Doi agenți, un repo și un panou GitHub Issues care ține totul laolaltă
Cum am rulat mai mulți agenți de programare în paralel pe aceeași bază de cod, fără conflicte de merge sau branch-uri lăsate la jumătate, folosind GitHub Issues ca panou de lucru, o regulă simplă pentru proprietatea fișierelor și un om la etapa de merge.
Aveam o aplicație web cu o listă de probleme. Analizele de cod au scos la iveală amestecul obișnuit: câteva probleme de securitate, niște interogări lente, o grămadă de inconsecvențe în denumiri și genul de cod mort pe care toată lumea îl ocolește. Nimic exotic. Doar mai mult decât voiam să rezolv manual și genul de muncă ușor de început și greu de terminat.
Voiam să pun niște agenți la treabă. Îngrijorarea era evidentă: dacă dai drumul la câțiva agenți pe aceeași bază de cod, apar conflicte de merge, branch-uri lăsate la jumătate și mai mulți boți care rescriu cu încredere același fișier în direcții opuse. Situația generală de „credeam că mai mult AI va rezolva problema”, care sfârșește prin a crea și mai multe probleme. Așa că, înainte să scriu cod, am petrecut o după-amiază cu partea care de obicei e sărită: cum coordonezi munca, tot fluxul, nu cum o faci.
Iată cum am organizat totul. Nu e un framework, dar a mers destul de bine încât să merite scris.
Panoul de lucru este pur și simplu GitHub Issues
Prima decizie a fost să nu construiesc un orchestrator. E tentant să scrii un planificator care atribuie sarcini, urmărește starea și pornește agenți. Pentru o listă limitată de curățenie, asta devine un proiect în sine și ar fi durat mai mult decât merita.
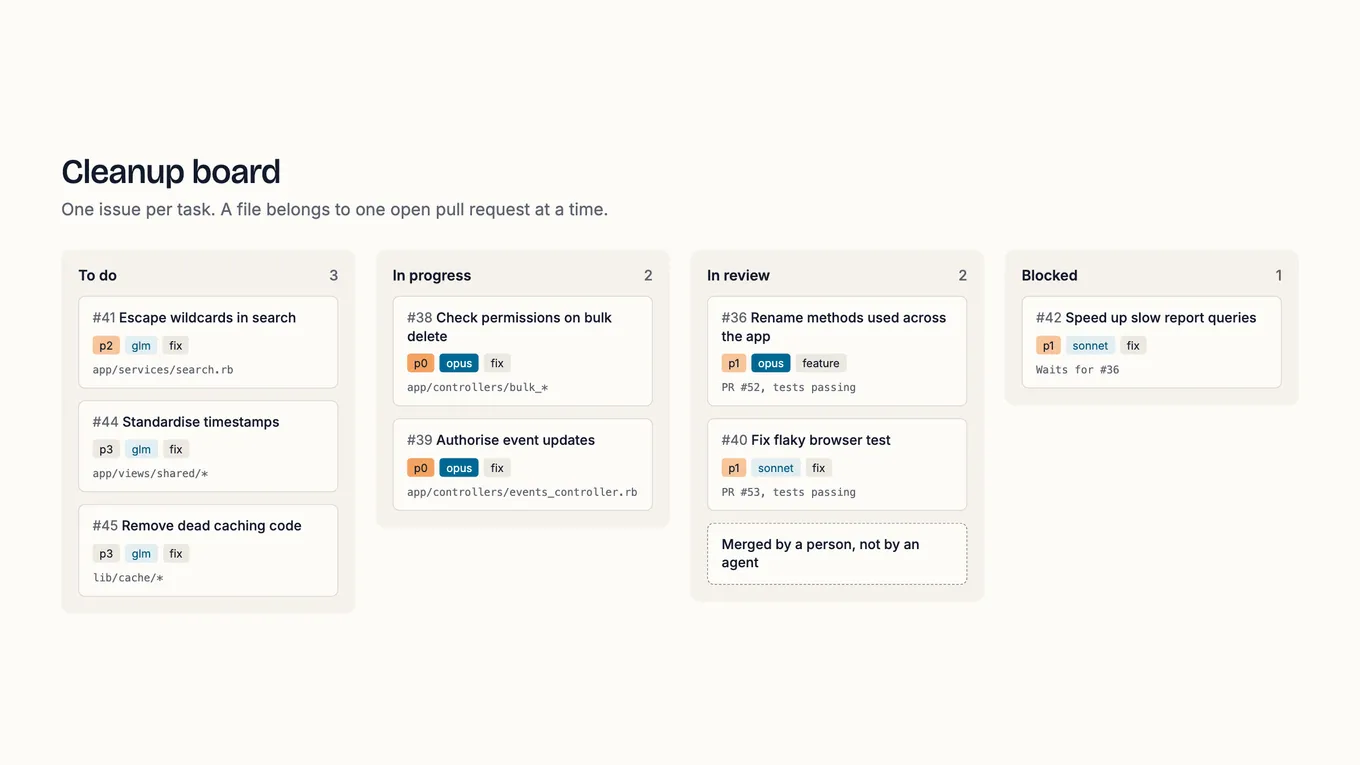
În schimb, sursa adevărului este GitHub Issues. Câte un issue pentru fiecare unitate de lucru. Un set mic de etichete face coordonarea:
- prioritate (
p0până lap3): ce e cu adevărat urgent - stare (
todo,wip,review,blocked): unde se află în flux - model (
opus,sonnet,glm): care agent ar trebui să o preia - culoar (
fix,feature): cât de greu trebuie să fie procesul
Poți prelua o sarcină dacă e todo, dependențele ei sunt închise și niciun pull request deschis nu atinge fișierele ei. Asta e toată regula. Nu există un server care să urmărească panoul și să împartă sarcini, fiindcă nu e nevoie de unul.
Harta statică a muncii (ce unitate deține ce fișiere, ce depinde de ce) trăiește într-un simplu fișier markdown în repo. Starea curentă este păstrată pe GitHub. Separarea acestor două lucruri a contat mai mult decât mă așteptam. Harta nu se schimbă în timp ce lucrezi; panoul da.
Singura regulă care face paralelismul sigur
Totul se sprijină pe o singură regulă: fiecare fișier sursă este deținut de cel mult un pull request deschis la un moment dat.
Dacă doi agenți nu ating niciodată același fișier, nu pot intra în conflict, iar eu pot analiza PR-urile lor în orice ordine. Așa că munca de la început a fost să tai lista de probleme în unități care nu se suprapun pe fișiere. Reparația de securitate pentru controlerele de ștergere în masă e o unitate. Autorizarea evenimentelor e alta. Serviciul de căutare e a treia. Fiecare numește exact fișierele pe care are voie să le atingă, iar eu am verificat că acele mulțimi nu se intersectează înainte să rulez ceva în paralel.
Rezultatul este un graf de dependențe. O redenumire trebuia integrată prima, pentru că schimba nume de metode apelate de jumătate din baza de cod, așa că tot restul aștepta în spatele ei. După aceea, un val de reparații fără legătură între ele putea rula deodată. Desenarea acelui graf a durat poate douăzeci de minute și m-a scutit de fiecare conversație de tipul „de ce e branch-ul ăsta plin de conflicte“.
Bineînțeles, și asta are limite, dar pe mine nu m-au deranjat de cele mai multe ori. Poți renunța la reguli și în timpul lucrului, dacă nu crezi că va ieși prea mult haos. Ideea nu e să-ți încarci fluxul cu reguli inutile, așa că urmează-le doar pe cele care te ajută.
Am folosit Claude Code și OpenCode
Cele două unelte nu vorbesc niciodată una cu alta, și e intenționat.
Am folosit Claude Code pentru munca unde a greși e scump: găurile de autorizare și bug-urile care duc la pierderi de date. Am folosit OpenCode pentru retușurile cu miză mică: escaparea unor caractere joker în căutare, ștergerea codului mort din cache, uniformizarea marcajelor de timp. Rutarea e doar o etichetă pe issue. Claude nu poate porni OpenCode și OpenCode nu poate porni Claude, și nici nu voiam să o facă. Ambele citesc aceleași issue-uri, urmează același ciclu de viață și deschid pull request-uri în același repo.
Fiecare sarcină rulează în propriul Git worktree, cu propria bază de date pentru teste. Așa, doi sau mai mulți agenți pot rula suita completă în același timp fără să-și strice datele unii altora. Worktree-urile fac parte din Git și e foarte simplu să lucrezi cu ele.
Ciclul fiecărei sarcini e plictisitor, și asta e bine, pentru că e previzibil. Trecem prin aceiași pași: preluăm issue-ul, creăm un branch nou, citim codul și scriem un test care pică și verifică comportamentul corect. Apoi îl facem să treacă, refactorizăm, rulăm linterul și scannerul de securitate, rulăm tot CI-ul local, deschidem un pull request și mutăm issue-ul pe review. Apoi STOP! Agentul nu face merge.
Oamenii mint mereu, iar uneori și testele (HouseMD)
Cel mai util principiu este, bineînțeles, că o suită de teste care trece nu înseamnă că programul e corect. Mai ales dacă testele au fost generate! Mai multe dintre bug-urile de securitate au avut teste verzi tot timpul. Se poate întâmpla ca testele să codifice comportamentul greșit și să afirme că o ștergere a reușit, fără să întrebe dacă persoana care ștergea avea voie. Așa că testul nou trebuie să pice mai întâi, și să pice pentru că vechiul comportament era greșit. Dacă nu-l poți face să pice, încă nu înțelegi bug-ul.
Fluxul a scos la iveală și câteva lucruri care nu aveau legătură cu reparațiile, ci cu infrastructura. Poarta de acoperire a testelor fusese configurată, dar nu era aplicată, așa că prima rulare reală a eșuat pe fișiere pe care nu le mai testase nimeni de luni de zile. Scriptul wrapper al scannerului de securitate forța un flag de „verifică dacă există o versiune mai nouă”, care făcea CI-ul să pice fiindcă apăruse o versiune patch upstream, nu pentru că găsise ceva.
Prefer să țin lucrurile în mâinile mele la finalul zilei
Revizuiesc și fac merge la fiecare pull request. Le testez, verific ce s-ar fi putut trece cu vederea și corectez greșelile apărute pe parcurs. Asta e limita deliberată a întregului sistem. Paralelismul nu ajută dincolo de cât pot revizui. Mai mulți agenți înseamnă doar o coadă mai lungă de PR-uri care mă așteaptă. De aceea rulez de obicei doi sau trei agenți odată, nu zece. În planul pe care îl folosesc nu există protecție pe branch, deci poarta de merge sunt literalmente eu, care nu integrez nimic ce e roșu sau nerevizuit. Pentru ce fac eu, e în regulă. Rolul fluxului nu e să mă elimine, ci să se asigure că, atunci când ajunge munca la mine, e deja testată, scanată și limitată la fișiere pe care le pot înțelege într-o singură sesiune de lucru.
Un mic lucru de ținut minte: dacă rulezi 5-10 sau mai mulți agenți odată, îți pot consuma tokenii foarte repede. Dacă îi rulezi local, se va simți și în consumul de RAM, mai ales dacă ajung la CI cam în același timp și ai o suită mare de teste. Îi poți rula și în cloud, dar și asta costă, deci depinde de situație. Pentru mine a fost în regulă așa. Și asta ne duce destul de bine la ultimul punct.
Cât a costat
Aproape nimic dincolo de apelurile către model. GitHub Issues, etichetele și pull request-urile sunt gratuite. gh CLI era deja instalat. Worktree-urile Git vin odată cu Git. Runnerul de teste, linterul și scannerul de securitate erau deja conectate în proiect. Singura cheltuială nouă sunt tokenii, iar rutarea ține modelul scump pe munca ce o merită, în timp ce cel ieftin se ocupă de curățenie și de lucrurile mai simple.
Pe scurt: poate ar trebui să stabilim înainte să începem ce fișiere intră în fiecare pull request, să păstrăm starea într-un loc pe care îl putem citi atât noi, cât și agenții, și să rămânem implicați măcar la final. Să-i pui pe agenți să scrie cod e ușor. Deschizi proiectul, pornești agentul preferat și gata. Să-i coordonezi și să păstrezi munca ușor de întreținut și de bună calitate e partea care cere gândire. Și, cel puțin deocamdată, tot noi ne ocupăm de asta.
Aveți o listă de sarcini pe care nu apucați niciodată să o terminați?
Punerea la punct a unei baze de cod îmbătrânite, închiderea unei liste de securitate și curățenie, sau mutarea de pe o platformă care vă încetinește. Exact acesta este genul de muncă cu care ajut afacerile mici și mijlocii. O evaluez cinstit, vă țin la curent și accept doar ceea ce chiar pot face bine.
Povestiți-mi despre proiectul dumneavoastră